Waarom het verbeteren van de datakwaliteit niet zozeer een IT-vraagstuk is

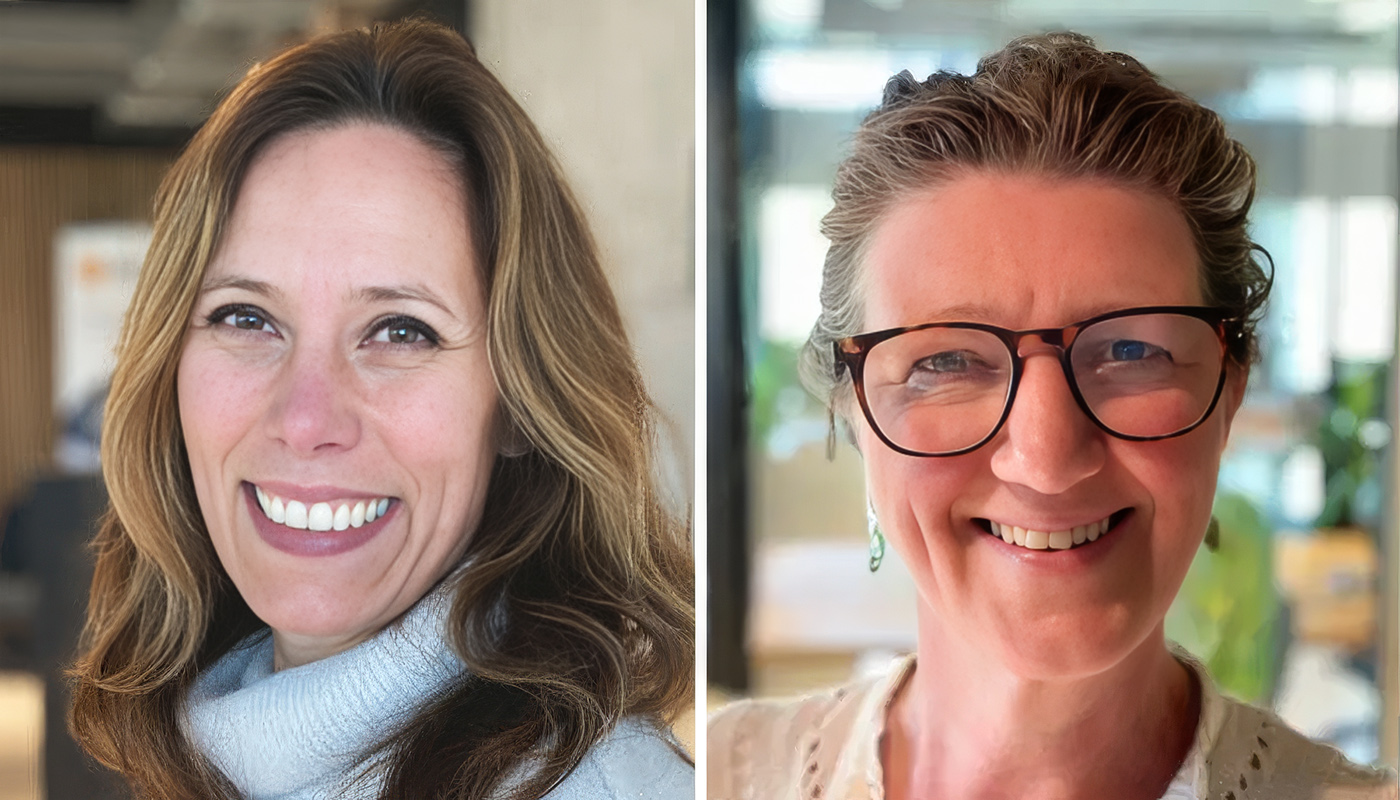
Het is een bekend probleem in organisatieland: datagedreven werken staat hoog op de agenda, maar de ambities lopen al snel vast omdat de kwaliteit van de data tekortschiet. Volgens Miranda Driessen en Majanka Loeff van Mobilee is dat niet zozeer een technisch probleem, maar bovenal een organisatorische uitdaging: “Organisaties die succesvol waarde creëren met data en AI investeren eerst in vertrouwen.”
Betrouwbare data is geen vanzelfsprekendheid. Gegevens worden dikwijls in verschillende systemen bijgehouden en het is lang niet altijd duidelijk wie verantwoordelijk is voor de kwaliteit ervan. Daardoor kunnen binnen een organisatie discussies ontstaan over welke cijfers al dan niet kloppen.
Dit wordt problematischer als organisaties steeds meer beslissingen baseren op data en AI-tools introduceren. Fouten, ontbrekende gegevens en verouderde informatie werken door in analyses en modellen. Investeren in nieuwe technologie heeft daardoor weinig zin als de kwaliteit van de onderliggende data achterblijft.
Technologie alleen is niet genoeg
Toch zien Driessen en Loeff dat veel organisaties het verbeteren van hun datakwaliteit nog te vaak behandelen als een technisch vraagstuk. Dat doet volgens de twee data- en transformatieconsultants geen recht aan de praktijk, waarin mensen, processen en systemen gezamenlijk de kwaliteit van data bepalen.
“Je kunt de meest innovatieve technologie inzetten, maar als de onderliggende data niet betrouwbaar is, bouw je een huis op drijfzand”, zegt Driessen.
Dat drijfzand kan verschillende vormen aannemen. Data wordt bijvoorbeeld op meerdere plekken opgeslagen; de klantenservice kan met een ander adressenbestand werken dan finance. Daarnaast gebruiken afdelingen meer dan eens verschillende definities. Daardoor kan zelfs als dezelfde databron wordt gebruikt onduidelijkheid ontstaan over begrippen als ‘actieve klant’.
“Het verbeteren van de datakwaliteit vraagt om gedragsveranderingen.”
Een ander knelpunt is het gebrek aan duidelijkheid rondom eigenaarschap. De IT-afdeling beheert de systemen, terwijl andere afdelingen verantwoordelijk zijn voor de gegevens die erin staan. Wie uiteindelijk toeziet op de kwaliteit van die data, is lang niet altijd helder.
“Het verbeteren van de datakwaliteit vraagt om gedragsveranderingen”, zegt Loeff. “Daarom moeten organisaties duidelijke afspraken maken over wie verantwoordelijk is voor de data, aan welke eisen die moeten voldoen en wat er gebeurt als de kwaliteit tekortschiet.”
Ook de manier waarop medewerkers worden aangestuurd, speelt een rol. Wie vooral wordt afgerekend op de snelheid waarmee gegevens worden geregistreerd, heeft minder ruimte om door te vragen of informatie zorgvuldig te controleren. Zo kunnen KPI’s onbedoeld ten koste gaan van de datakwaliteit.
Niet iedere dataset hoeft perfect te zijn
Dat betekent niet dat iedere dataset foutloos moet zijn. Datakwaliteit is afhankelijk van het doel waarvoor gegevens worden gebruikt. Voor sommige toepassingen is maximale nauwkeurigheid noodzakelijk, terwijl voor trend- of prognosemodellen de hoeveelheid beschikbare gegevens soms zwaarder weegt.
Om die afweging concreet te maken, werkt Mobilee met vijf kwaliteitsdimensies: volledigheid, nauwkeurigheid, consistentie, actualiteit en uniekheid. Organisaties kunnen vervolgens per dataset bepalen welke dimensies belangrijk zijn en daar meetbare normen aan verbinden.
“Bij een klant van ons – energiebedrijf Alliander – gebeurt dat bijvoorbeeld bij de operationele planning”, zegt Loeff. “Daar is het belangrijk om te weten wanneer monteurs beschikbaar zijn. Als hun afwezigheid in 95% van de gevallen correct en op tijd in het systeem staat, kan de organisatie besluiten dat die betrouwbaarheid voor de planning voldoende is. De resterende 5% wordt dan als acceptabel bedrijfsrisico gezien.”
“Zo verschuift de discussie van gevoel naar feit en ontstaat er een gedeeld referentiekader”, vult Driessen aan. “De vraag wordt daarmee niet langer of data in algemene zin ‘goed’ is, maar welke kwaliteit voor een specifieke toepassing noodzakelijk is.”
AI stelt hogere eisen aan data
De opkomst van AI maakt goede datakwaliteit nog belangrijker. Mobilee onderzocht bij de Immigratie- en Naturalisatiedienst (IND) hoe AI de businessanalisten kan ondersteunen. Daar bleek dat niet alleen de technologie bepalend is voor het resultaat: ook de gegevens waarmee een AI-toepassing werkt, moeten betrouwbaar en bruikbaar zijn.
“AI kan processen versnellen en medewerkers ondersteunen, maar de uitkomsten zijn afhankelijk van de informatie die je erin stopt”, zegt Loeff. “Zijn gegevens onvolledig, spreken verschillende bronnen elkaar tegen of is informatie moeilijk te vinden, dan neemt ook de betrouwbaarheid van de uitkomsten af.”
Volgens Driessen en Loeff moeten organisaties daarom eerst bepalen welke gegevens voor een AI-toepassing belangrijk zijn en hoe betrouwbaar die moeten zijn. Vervolgens is het onder meer zaak om te onderzoeken waar fouten kunnen ontstaan.
“Het verbeteren van de datakwaliteit is een doorlopend proces.”
Veel fouten kunnen al bij de invoer worden voorkomen. Organisaties kunnen bijvoorbeeld verplichte velden gebruiken, medewerkers laten kiezen uit vaste antwoordmogelijkheden en automatisch controleren of ingevoerde gegevens logisch zijn. “Medewerkers moeten dus weten wat er van hen wordt verwacht en waarom dat belangrijk is”, zegt Driessen.
Begin met één belangrijke dataset
Om de kwaliteit van data blijvend te verbeteren, moet bovenal duidelijk zijn wie waarvoor verantwoordelijk is. Organisaties moeten daarom per belangrijke dataset bepalen wie beslissingen neemt over de gegevens en wie in de dagelijkse praktijk controleert of ze correct worden vastgelegd en gebruikt.
Ook moeten vooraf afspraken worden gemaakt over de gewenste kwaliteit. Welke fouten zijn nog acceptabel? Wanneer moeten gegevens worden gecorrigeerd? En wie grijpt in als de kwaliteit onder de afgesproken norm zakt?
Volgens Driessen hoeft een organisatie dat niet meteen voor alle beschikbare data te regelen. “Begin met één kritieke dataset, stel een eigenaar aan, maak afspraken over definities en leg vast hoe je kwaliteit meet. Als die werkwijze in de praktijk functioneert, kan een organisatie deze vervolgens uitbreiden naar andere gegevens en processen.”
Vertrouwen vóór technologie
Daarmee wordt het verbeteren van datakwaliteit geen eenmalig project om fouten uit sets te halen, maar onderdeel van de dagelijkse bedrijfsvoering. “Het is een doorlopend proces, dat stevig verankerd moet worden in het DNA van je organisatie”, benadrukt Loeff. “Het vraagt om duidelijke keuzes, expliciet eigenaarschap en aandacht voor mens en gedrag.”
“Organisaties die succesvol waarde creëren met data en AI investeren daarom niet als eerste in technologie”, concludeert Driessen. “Ze investeren eerst in vertrouwen. Dat vertrouwen ontstaat als medewerkers weten wat gegevens betekenen, hoe betrouwbaar ze zijn en wie verantwoordelijk is voor de kwaliteit ervan.”